Cuando un flujo de trabajo depende de media docena de plataformas diferentes, la eficiencia operativa se convierte en una ventaja evidente. Un formulario web recopila los datos de un cliente potencial, una herramienta de enriquecimiento añade información fiscal, un CRM registra el contacto, una pasarela de pago genera la factura y, finalmente, un canal interno de mensajería avisa al equipo comercial. Todo ocurre en cuestión de segundos sin intervención humana. Sin embargo, este engranaje perfecto oculta una vulnerabilidad estructural que rara vez se evalúa durante la fase de diseño inicial.
El problema real no surge cuando todas las aplicaciones operan dentro de sus parámetros habituales. El fallo se manifiesta el día en que una de esas piezas intermedias sufre una caída temporal de servicio, modifica su API sin previo aviso o rechaza una credencial de acceso por motivos de seguridad. En ese instante, la cadena lógica se interrumpe de forma abrupta. Sin una estrategia defensiva adecuada, el sistema no solo detiene su ejecución actual, sino que puede corromper la información acumulada, duplicar registros previos o dejar transacciones comerciales en un estado intermedio imposible de auditar sin revisar manualmente cada base de datos implicada.
Comprender las consecuencias de una interrupción parcial en un ecosistema tecnológico interconectado exige analizar el comportamiento técnico de los sistemas distribuidos. En entornos corporativos donde cada minuto de inactividad operativa se traduce en retrasos administrativos o fricción con los clientes, anticiparse al punto exacto de rotura deja de ser una tarea técnica opcional. Requiere revisar los protocolos de comunicación, la gestión de excepciones y los límites de tolerancia al fallo que sustentan la infraestructura diaria de la empresa.
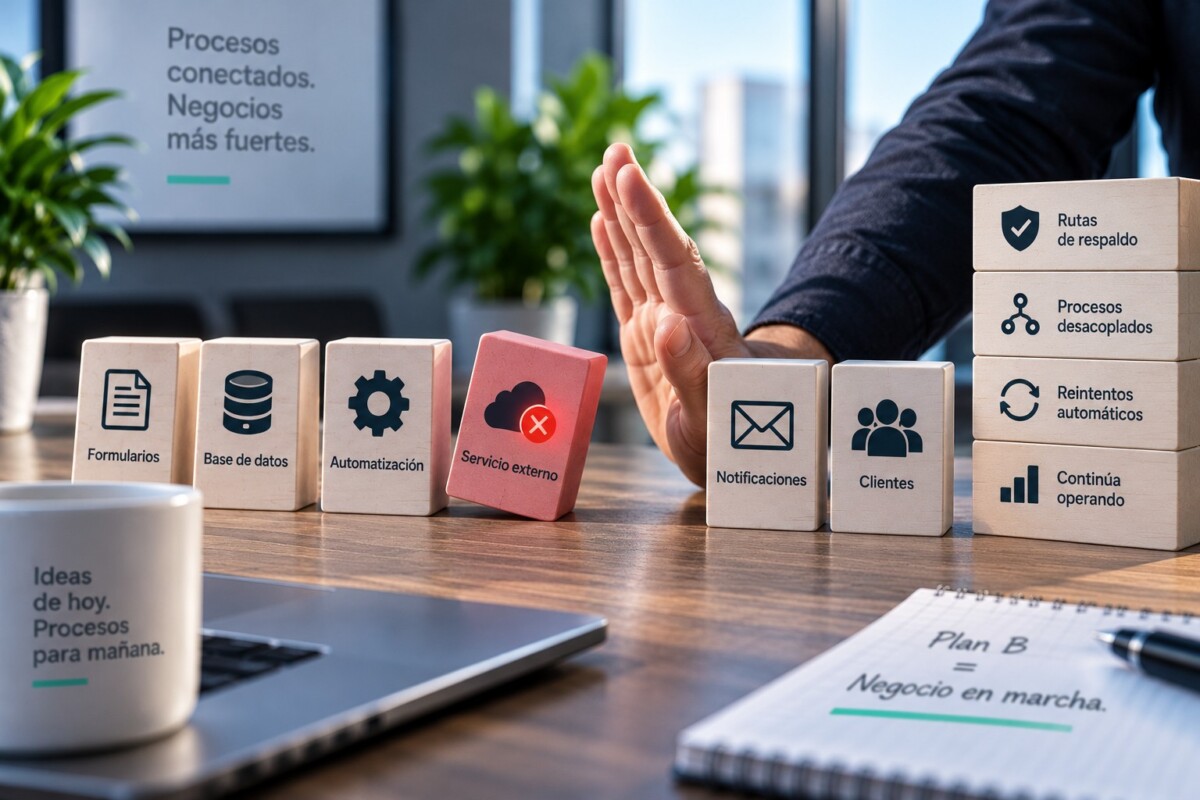
El efecto dominó en los flujos de trabajo hiperconectados
Una automatización moderna funciona mediante una secuencia ordenada de llamadas HTTP, webhooks y consultas a bases de datos. Cuando el primer nodo del flujo recibe un evento, transfiere un paquete de datos estructurados al siguiente eslabón. Si el tercer sistema de la cadena experimenta un error interno de servidor o un tiempo de espera agotado, la ejecución se congela. Las herramientas situadas aguas arriba ya han completado su tarea, mientras que las aplicaciones situadas aguas abajo jamás reciben la información necesaria para activar sus propias rutinas.
Este comportamiento genera un escenario conocido como pérdida de visibilidad operativa. Para el responsable de operaciones, el proceso parece haberse ejecutado correctamente porque el formulario inicial se envió y el cliente recibió una confirmación genérica. No obstante, el registro comercial nunca llegó al CRM ni se generó la tarea de seguimiento correspondiente. La desconexión entre la percepción del usuario y el estado real de los sistemas informáticos dificulta la detección temprana del problema, permitiendo que los errores se acumulen durante horas antes de que alguien note la ausencia de datos.
Para profundizar en cómo prevenir estas deficiencias estructurales, resulta útil revisar los criterios analizados en cómo diseñar procesos que no se rompan al aumentar el volumen. La fragilidad operativa rara vez proviene de un único fallo catastrófico; se manifiesta mediante pequeñas desviaciones acumulativas que superan la capacidad de respuesta de los sistemas cuando la complejidad del flujo supera los límites previstos por el equipo técnico.
Además, la dependencia de servicios externos expone a la pyme a factores que escapan a su control directo. Las modificaciones en las políticas de uso de una API comercial, la expiración de un certificado SSL o una actualización menor en el esquema de respuesta JSON de un proveedor pueden invalidar por completo un nodo previamente estable. Si el flujo de trabajo carece de mecanismos de validación estrictos, los datos corruptos o incompletos avanzarán por la cadena, generando un impacto mucho mayor que la simple interrupción temporal del servicio.
Cómo actúan las plataformas de integración ante una respuesta nula
Los motores de orquestación actuales se apoyan en soluciones y herramientas especializadas, tal como se detalla en guías sobre automatización para agilizar procesos, para procesar ejecuciones concurrentes bajo premisas lógicas predefinidas. Cuando un nodo realiza una solicitud a una API externa y recibe un código de error HTTP 500 o un tiempo de espera superior al configurado, el comportamiento predeterminado suele ser la detención inmediata del flujo. Esta respuesta inmediata protege contra la propagación de datos erróneos, pero interrumpe la continuidad operativa si no existen instrucciones alternativas programadas en el sistema.
Configurar adecuadamente los parámetros de reintento es una de las primeras líneas de defensa técnica. En lugar de aceptar el fallo en el primer intento, el sistema puede programarse para esperar un intervalo incremental antes de lanzar una nueva consulta. Esta práctica absorbe caídas breves de los servidores externos sin requerir la intervención del personal técnico. Sin embargo, los reintentos automáticos deben limitarse mediante políticas estrictas para evitar la saturación de peticiones sobre una API que ya se encuentra experimentando problemas de rendimiento o bloqueos por exceso de tráfico.
Cuando un servicio externo deja de responder de manera prolongada, la estrategia de aislamiento evita que toda la automatización quede bloqueada. En lugar de retener indefinidamente los recursos del servidor de ejecución, el sistema archiva el contexto de la tarea fallida en una cola de mensajes o en una tabla de control interna. De este modo, los operarios pueden revisar y reintentar las operaciones acumuladas una vez que el proveedor externo haya restablecido sus servicios por completo, garantizando la integridad de la información empresarial.
Estrategias de diseño defensivo para proteger la infraestructura
Construir un flujo de trabajo robusto exige adoptar principios de ingeniería de software clásica, inspirados en conceptos como el diseño defensivo aplicado al ámbito de la automatización sin código o de código bajo. El diseño defensivo parte de la premisa de que cualquier servicio externo fallará en el momento más inesperado. Por esta razón, cada conexión entre herramientas diferentes debe contemplar escenarios alternativos para cuando la respuesta no sea la esperada o el tiempo de espera supere el umbral establecido.
Una medida fundamental consiste en implementar validaciones estrictas de los datos de entrada y salida en cada nodo intermedio. Utilizar esquemas de comprobación formalizados asegura que la estructura del JSON recibido coincida exactamente con lo esperado antes de enviarlo al siguiente sistema. Si una herramienta devuelve un campo vacío o un formato alterado, el flujo detecta la anomalía de forma temprana, evitando que las aplicaciones posteriores procesen información corrupta que resulte difícil de depurar posteriormente.
Asimismo, es recomendable establecer sistemas de notificación interna independientes de las herramientas que participan en el proceso principal. Si el flujo utiliza un servicio de mensajería para comunicarse con el equipo, depender exclusivamente de ese mismo canal para reportar un fallo en la entrega de mensajes genera un punto ciego crítico. Contar con rutas de alerta alternativas, como registros centralizados en bases de datos locales o avisos por correo electrónico mediante pasarelas independientes, asegura que el equipo técnico reciba la información del error en tiempo real.
Para ampliar las pautas sobre la gestión de incidencias imprevistas en arquitecturas automatizadas, se puede consultar el análisis sobre cómo gestionar las excepciones en los flujos de trabajo empresariales. La preparación ante el fallo no busca eliminar por completo la posibilidad de que una herramienta deje de responder, sino dotar a la organización de los mecanismos necesarios para absorber el impacto sin comprometer la continuidad del negocio.
Protocolos de recuperación y mantenimiento evolutivo
La estabilidad a largo plazo de una automatización compleja no se limita al diseño inicial del flujo; depende directamente de la estrategia de mantenimiento evolutivo que aplique la empresa, un aspecto analizado en profundidad en recursos sobre mantenimiento evolutivo vs correctivo en software. A medida que las herramientas del ecosistema digital se actualizan, las integraciones tienden a acumular deuda técnica que debilita su resistencia ante imprevistos. Establecer rutinas periódicas de auditoría sobre las conexiones activas permite detectar modificaciones en las especificaciones de las APIs antes de que provoquen interrupciones operativas en la operativa diaria.
El uso de entornos de prueba separados de producción resulta indispensable cuando se modifican flujos que conectan múltiples plataformas. Desplegar una actualización directamente sobre el entorno operativo en vivo multiplica el riesgo de colapso si una de las herramientas integradas responde de manera diferente a la esperada. Simular escenarios de fallo controlado mediante la interrupción intencionada de conexiones específicas ayuda a comprobar si los mecanismos de recuperación alternativos responden según lo previsto y si las alertas internas se activan correctamente.
Además, es necesario documentar con precisión la arquitectura lógica de cada automatización para evitar la dependencia exclusiva de la persona que diseñó el sistema original. Cuando un flujo interconecta cinco herramientas y una de ellas deja de responder, el tiempo de resolución depende directamente de la claridad con la que el equipo técnico pueda rastrear el origen del fallo a través de los registros de ejecución. Disponer de trazabilidad transparente y documentación actualizada transforma un incidente crítico en una incidencia controlada y de rápida resolución.
Para asegurar que la infraestructura tecnológica mantenga sus niveles óptimos de rendimiento y seguridad ante el crecimiento operativo, el soporte especializado resulta clave. Puedes consultar nuestra metodología de trabajo en nuestro proceso de implantación o evaluar las opciones de integración avanzada visitando nuestros servicios de automatización inteligente orientados a proteger la estabilidad de tu negocio.
Preguntas frecuentes
¿Qué ocurre con los datos que se están procesando justo en el momento en que una herramienta deja de responder?
Depende de la configuración del motor de automatización y de la fase en la que se encontrara el flujo. Si la petición no recibió confirmación, la ejecución suele detenerse en ese punto exacto. Sin una gestión de reintentos o una cola de almacenamiento temporal, los datos que no llegaron a registrarse en el sistema de destino pueden perderse o requerir una recuperación manual a partir de los registros de auditoría de la plataforma de origen.
¿Cómo se puede evitar que la caída de una API externa bloquee toda la operativa de la empresa?
La solución técnica consiste en implementar nodos de control de errores y rutas alternativas en la arquitectura del flujo. En lugar de detener la ejecución de forma indefinida ante un código de error del servidor externo, el sistema debe derivar la tarea afectada hacia una tabla de excepciones o una cola de espera, permitiendo que el resto de procesos independientes continúen operando con normalidad hasta que el servicio afectado se restablezca.
¿Es necesario revisar las automatizaciones aunque funcionen correctamente desde hace meses?
Sí, de forma periódica. Los proveedores de servicios digitales actualizan frecuentemente sus interfaces de programación, modifican los esquemas de datos o alteran las políticas de autenticación y seguridad. Una automatización estable puede dejar de responder de un día para otro debido a un cambio menor en una de las herramientas conectadas, por lo que resulta imprescindible realizar auditorías técnicas y pruebas de validación de manera regular.