Una pyme conectada a múltiples servicios digitales suele construir su operativa diaria sobre una red invisible de conexiones entre sistemas. Un software de facturación se comunica con una pasarela de pagos. Un CRM recibe datos de formularios web. Un gestor de inventario actualiza stock mediante consultas programadas a proveedores logísticos. Cada uno de estos puentes digitales se apoya en interfaces de programación de aplicaciones, conocidas comúnmente como APIs. Cuando estos canales funcionan de manera fluida, la empresa procesa pedidos, avisa a clientes y registra transacciones sin intervención humana. Sin embargo, este engranaje descansa sobre una infraestructura que la organización no controla.
Los proveedores de servicios tecnológicos modifican sus interfaces de programación de forma periódica. Actualizan versiones, modifican estructuras de datos, deprecian parámetros obligatorios o alteran los métodos de autenticación por motivos de seguridad o estrategia comercial. Si una pyme diseña sus flujos de trabajo asumiendo que una API externa mantendrá su comportamiento invariable para siempre, el día que se produzca una alteración imprevista, la operativa puede detenerse por completo. Un cambio en una clave de respuesta o en el formato de un objeto JSON puede romper el flujo de trabajo en cuestión de segundos, generando errores en cascada que paralizan la actividad comercial o administrativa sin que el equipo directivo perciba el origen del problema de inmediato.
Comprender la naturaleza de estas dependencias resulta indispensable para cualquier organización que dependa de la tecnología para operar con agilidad. Los sistemas modernos de integración, como se detalla en las directrices sobre seguridad y diseño defensivo analizadas en este artículo especializado en buenas prácticas para APIs, requieren un enfoque que contemple el fallo como un escenario normal y esperable. No se trata de buscar soluciones infalibles, sino de construir arquitecturas capaces de absorber modificaciones imprevistas sin comprometer la continuidad del negocio.
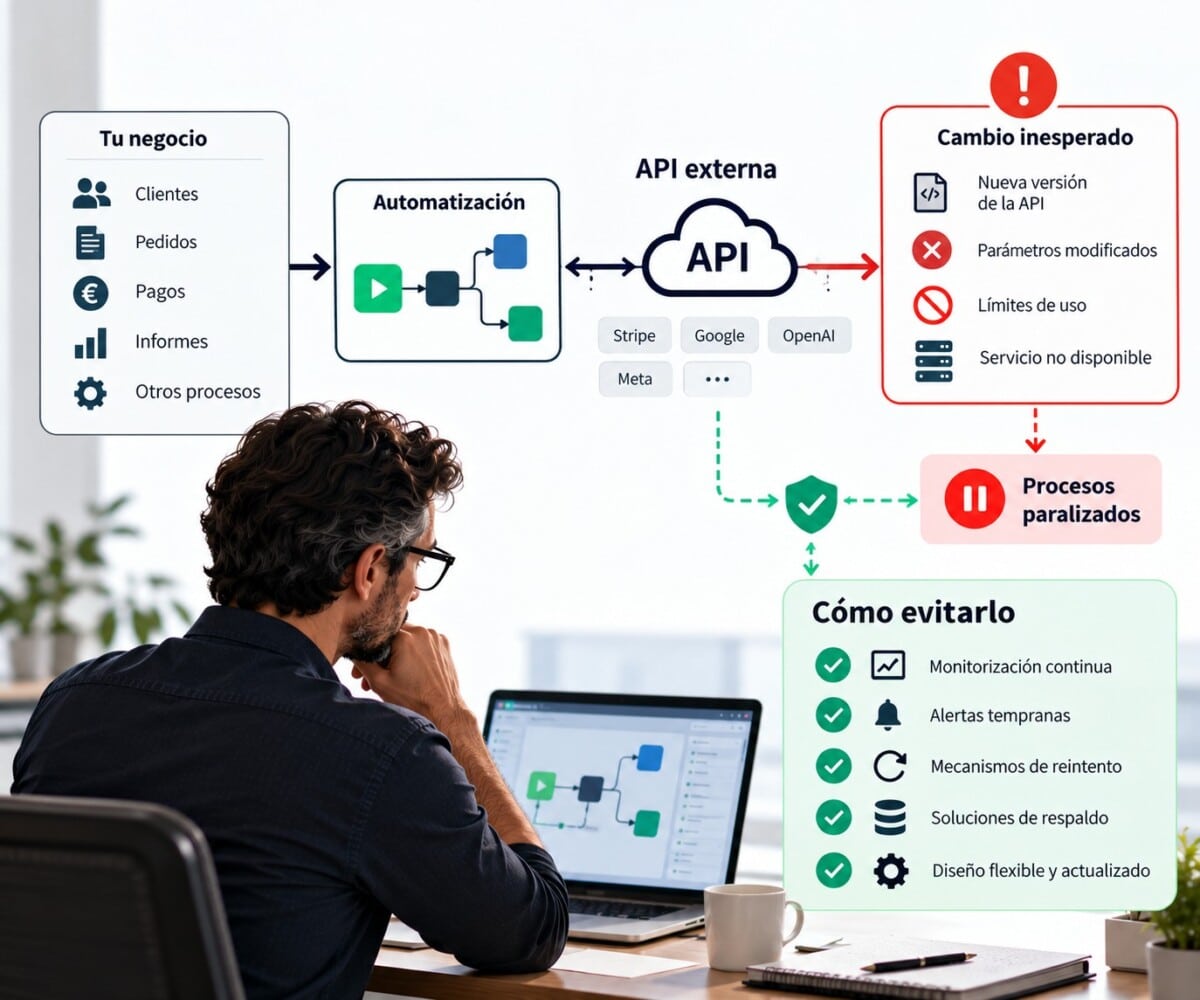
A lo largo de este análisis, revisaremos los puntos críticos donde estas rupturas operativas suelen manifestarse, las consecuencias de mantener una confianza ciega en las respuestas de terceros y los mecanismos de ingeniería necesarios para aislar a tu empresa frente a modificaciones unilaterales en plataformas ajenas.
La falsa estabilidad de las interfaces de terceros
Existe una tendencia generalizada a tratar las integraciones con software externo como si se tratara de herramientas instaladas de manera local en los servidores de la propia empresa. Cuando una pyme contrata un servicio en la nube para gestionar su contabilidad o su atención al cliente, confía en que las reglas de intercambio de información permanecerán estables. No obstante, las empresas que desarrollan estas plataformas evolucionan sus productos atendiendo a sus propios intereses estratégicos, lo que incluye la modificación de contratos de datos sin previo aviso detallado para cada cliente final.
Un proveedor puede decidir que un campo numérico que hasta ayer se enviaba como un entero pase a enviarse como una cadena de texto, o que un parámetro opcional en la creación de clientes sea ahora obligatorio. Para un sistema automatizado que procesa esa información de manera estrictamente tipada, esta simple modificación provoca una interrupción inmediata en la ejecución. El nodo encargado de procesar la respuesta se detiene al no encontrar la estructura esperada, arrojando un error técnico que detiene el flujo completo. Si esta rutina ejecutaba la validación de un pedido o la emisión de una factura, la consecuencia directa es la retención de ingresos o la frustración de un cliente.
Las organizaciones suelen descubrir estas incidencias únicamente cuando los usuarios internos reportan que una tarea rutinaria ha dejado de completarse. Esta falta de visibilidad previa demuestra que la infraestructura tecnológica operaba bajo una dependencia frágil. Como se analiza en este análisis sobre la interconexión de plataformas, una cadena de integraciones es tan resistente como su eslabón más débil, y confiar en la estabilidad a largo plazo de un servicio ajeno sin contenciones propias equivale a dejar la operativa comercial a merced de decisiones ajenas.
Para mitigar este riesgo, los equipos técnicos deben asumir que cualquier integración externa cambiará en el momento menos oportuno. Esta premisa obliga a implementar capas intermedias de validación que actúen como un escudo protector frente a modificaciones en los contratos de datos, evitando que un cambio menor en el origen se convierta en una crisis operativa interna.
Estrategias de aislamiento y validación de esquemas
La defensa más eficaz frente a las modificaciones inesperadas en una interfaz externa consiste en no permitir que los datos crudos procedentes del exterior entren directamente en la lógica central de los procesos de negocio. En lugar de conectar la API directamente con los puntos de toma de decisiones o con las bases de datos corporativas, la arquitectura debe incorporar una capa de normalización y validación estricta de esquemas.
Esta capa intermedia funciona como un filtro aduanero. Cuando el sistema recibe una respuesta de la API externa, antes de ejecutar cualquier acción posterior, el flujo de trabajo comprueba que la estructura recibida coincide exactamente con el formato esperado. Si el proveedor externo ha eliminado un campo o ha modificado su tipo de datos, el sistema de validación intercepta la anomalía en el mismo momento de la recepción. En lugar de detener el proceso de forma abrupta o corromper los registros internos con datos malformados, el flujo activa una rutina de contingencia.
Para profundizar en cómo manejar estas desviaciones de comportamiento y estructurar planes de respuesta ante incidencias de integración, resulta de gran utilidad examinar los enfoques metodológicos disponibles en esta guía sobre mantenimiento preventivo en sistemas tecnológicos. La validación perimetral garantiza que las anomalías técnicas sean tratadas como excepciones controladas y no como catástrofes operativas.
Además, cuando una modificación en el proveedor externo invalida temporalmente la integración, disponer de un mecanismo de aislamiento permite que el resto de los procesos de la empresa sigan funcionando con normalidad. Si la conexión con una pasarela de pagos secundaria falla debido a un cambio en su API, el flujo puede desviar la transacción hacia un canal alternativo o retener la solicitud en una cola de espera segura para su revisión posterior, protegiendo la experiencia del cliente final.
Mecanismos de recuperación ante fallos de conectividad y respuestas erróneas
Un cambio en una API externa no siempre se manifiesta como una modificación en la estructura de los datos; con frecuencia se presenta como una interrupción total del servicio, una latencia extrema que agota los tiempos de espera o la devolución de códigos de error HTTP de servidor. Ante estos escenarios, un diseño de automatización rígido reacciona deteniéndose por completo y acumulando ejecuciones fallidas que saturan los registros del sistema.
Para evitar que una caída puntual del servicio externo paralice la actividad de la pyme, es necesario implementar políticas de reintento estructurado, conocidas técnicamente como *retries* con retroceso exponencial. En lugar de reintentar la conexión de manera inmediata y saturar al servidor externo que ya presenta problemas, el sistema espera intervalos progresivos antes de lanzar una nueva consulta. Si el fallo persiste tras agotar los intentos configurados, la ejecución debe derivarse hacia una estructura de almacenamiento temporal de seguridad.
Este enfoque metodológico coincide con los principios de resiliencia operativa expuestos en la gestión de colas de mensajes fallidos, donde se detalla cómo preservar la información que no pudo procesarse para evitar su pérdida definitiva. Ningún dato generado por la actividad comercial de la empresa debe desaparecer simplemente porque un servicio intermediario externo haya dejado de responder temporalmente.
Asimismo, la observabilidad juega un papel determinante. Los responsables de operaciones de la pyme deben recibir alertas precisas y contextualizadas cuando una API externa comience a arrojar respuestas anómalas, mucho antes de que el impacto económico sea perceptible. Herramientas de monitorización orientadas a negocio permiten identificar si el problema radica en un cambio de versión no comunicado o en una simple caída temporal de infraestructura.
Gobernanza y mantenimiento preventivo de integraciones
La estabilidad a largo plazo de las automatizaciones que dependen de servicios externos no se logra únicamente mediante un buen diseño inicial, sino a través de una gobernanza técnica continuada. Las empresas tecnológicas que operan plataformas de software como servicio suelen publicar avisos de depreciación de endpoints y modificaciones en sus hojas de ruta con varias semanas o meses de antelación. Ignorar estas comunicaciones comerciales o técnicas expone a la pyme a sorpresas innecesarias el día en que el cambio entra en vigor.
Establecer un protocolo interno de revisión periódica de integraciones reduce drásticamente el factor sorpresa. Este mantenimiento preventivo implica comprobar de forma rutinaria los registros de actividad de las conexiones principales, verificar si existen advertencias en las respuestas de las APIs utilizadas y mantener actualizados los entornos de prueba o *staging* donde se simulan las llamadas antes de llevar los cambios a producción. Como se explica en las guías de control de versiones para flujos de trabajo, documentar cada modificación y disponer de copias de seguridad de las versiones estables anteriores permite revertir cualquier cambio desastroso en cuestión de minutos.
A la hora de evaluar incidencias recurrentes y comprobar el estado de los componentes interconectados, la experiencia comunitaria ofrece perspectivas muy valiosas que se pueden consultar en este debate sobre diagnóstico y resolución de errores críticos de integración, donde se reflexiona sobre cómo afrontar paradas inesperadas en procesos automatizados complejos.
La responsabilidad última sobre la continuidad de los procesos automatizados recae en la propia organización y no en los proveedores tecnológicos externos. Asumir que las interfaces de terceros son volubles por naturaleza transforma la manera en que se concibe la arquitectura digital de la pyme, desplazando la confianza ciega hacia una estrategia basada en la verificación constante, el aislamiento de riesgos y el control absoluto de las excepciones operativas.
Para evaluar cómo estructurar de forma integral la tecnología de tu empresa y blindar tus flujos frente a dependencias externas complejas, puedes consultar los detalles sobre nuestra metodología en nuestros servicios de arquitectura y automatización o revisar los diferentes enfoques estratégicos disponibles en nuestra sección de seguridad tecnológica, así como explorar más contenidos especializados en nuestro archivo de artículos.
Preguntas frecuentes
¿Por qué una API externa puede cambiar su estructura sin avisar previamente?
Los proveedores tecnológicos actualizan sus plataformas de manera continua para corregir vulnerabilidades, mejorar el rendimiento o desplegar nuevas funcionalidades comerciales. Aunque muchos servicios emiten avisos de depreciación, las modificaciones menores en los tipos de datos o en los parámetros opcionales a menudo se implementan con margen de preaviso reducido, afectando a las integraciones rígidas que no validan los esquemas de entrada.
¿Qué ocurre con los datos de mis clientes si una API externa deja de responder durante horas?
Si la automatización carece de sistemas de contención, las transacciones se detienen y la información puede perderse o quedar en un estado inconsistente. Una arquitectura resiliente utiliza colas de aislamiento temporal para retener los datos entrantes de forma segura hasta que el servicio externo recupera la conectividad o el equipo técnico interviene el proceso.
¿Cómo puedo enterarme de un fallo en una integración antes de que afecte a la facturación?
Es necesario configurar mecanismos de observabilidad de negocio que vigilen el contenido de las respuestas y no solo la disponibilidad técnica del servidor. Si una API responde correctamente pero devuelve datos vacíos o con errores de esquema, el sistema debe disparar alertas automáticas al responsable de operaciones antes de que el impacto económico sea visible.